AI 발전 역사: 컴퓨터는 어떻게 사람처럼 말하게 됐을까?
AI의 언어 학습은 규칙 기반에서 통계 확률, 단어 의미, 문맥 이해로 70년간 진화해 왔습니다.
 아서
포인트 요약
AI는 1950년대 사람이 입력한 규칙만 따르던 단계에서 시작해, 1990년대 통계 확률로 패턴을 학습하는 머신러닝 시대를 거쳤습니다.
2010년대 워드투벡으로 단어의 의미를 파악하게 됐고, 2017년 트랜스포머 아키텍처가 등장하며 문장 전체의 문맥을 이해하는 능력을 갖추게 됐습니다.
ChatGPT로 대표되는 현재의 대형 언어 모델은 뛰어난 언어 생성력을 보여주지만, 환각 현상과 인과관계 추론의 한계는 여전히 해결 과제로 남아 있습니다.
이제는 AI 없이 생활하기가 답답할 만큼 AI가 삶의 일부가 됐습니다.
ChatGPT 공개를 기점으로 생성형 AI가 대중화됐는데요,
사실 AI는 수십 년 전부터 발전을 거듭해 온 기술입니다.
컴퓨터가 사람의 말을 이해하도록 만드는 기술이 그 중심이었고, 중간중간 암흑기도 있었습니다.
사람이 정해준 규칙대로만 움직이던 컴퓨터가 어떻게 스스로 언어를 배우고 문맥까지 이해하게 됐는지, 그 흐름을 정리해보겠습니다.
■ 규칙만 따르던 AI, 어떻게 시작됐을까? (1950~70년대)
1️⃣ AI 개념의 등장
1950년 앨런 튜링이 기계의 지능을 측정하는 '튜링 테스트'를 제안하며 초석을 다졌고, 1956년 다트머스 회의에서 '인공지능
(Artificial Intelligence)'이라는 용어가 공식적으로 쓰였습니다. 당시는 수년 내에 인간 수준의 AI가 나올 것이라는 낙관론이 지배적이었습니다.
2️⃣ 규칙 기반 언어 처리
초기 AI의 언어 학습은 과학자와 언어학자가 미리 짜놓은 빽빽한 규칙과 단어 사전 안에서만 작동했습니다.
스스로 생각하기보다, 문장 구조를 분석하는 '문법 파서(Parser)'나 고유명사를 찾는 사전 시스템에 전적으로 의존했습니다.
3️⃣ 최초의 챗봇 ELIZA (1966년)
MIT의 조셉 와이젠바움 교수가 만든 ELIZA는 가장 초기의 대화형 챗봇입니다.
사용자가 특정 단어를 말하면 미리 입력된 규칙에 따라 대답을 매칭하는 단순한 구조였지만, 파급력은 대단했습니다.
4️⃣ 첫 번째 암흑기
하지만 사람이 모든 예외와 문법 규칙을 일일이 손으로 적어야 했기에, 정해진 규칙을 벗어나면 대답하지 못했습니다.
느린 성능과 메모리 부족까지 겹치며 AI 연구는 가시적 성과를 내지 못했고, 첫 번째 암흑기(AI Winter)를 맞습니다.
■ AI는 어떻게 확률을 계산하기 시작했을까? (1980~90년대 초)
1️⃣ 전문가 시스템의 유행
AI는 만능 지능 대신 '특정 분야 전문가'로 전략을 바꿔 다시 등장했습니다.
의료 진단이나 지질 조사처럼 특정 분야 지식을 규칙(If-Then) 형태로 대량 입력해 문제를 푸는 시스템이 기업을 중심으로 도입됐습니다.
2️⃣ 통계 확률 모델의 도입
언어 처리에서도 큰 전환이 일어났습니다. 인간이 규칙을 직접 가르치는 대신, 대규모 텍스트를 분석해 스스로 확률적 규칙을 찾기 시작한 것입니다. 은닉 마르코프 모델(HMM)이나 최대 엔트로피 모델(MEM) 같은 통계 방법론이 본격 도입돼, 단어와 품사의 등장 확률을 계산하며 품사 구별·기계 번역·음성 인식을 수행했습니다.
3️⃣ 두 번째 암흑기
그러나 전문가 시스템은 유지보수 비용이 너무 컸고 예외에 취약했습니다. 언어 분야도 단어 사이의 복잡한 관계를 단순 통계로 담기엔 한계가 컸고 연산 속도도 부족해, 두 번째 암흑기가 찾아옵니다.
■ 데이터가 쌓이자 무엇이 달라졌을까? (1990년대 후반~2010년대 초)
1️⃣ 머신러닝으로의 전환
인터넷 보급으로 방대한 데이터가 쌓이고 성능이 비약적으로 발전하면서, 데이터로부터 패턴을 학습하는 '머신러닝' 시대로 진입합니다. 1997년 IBM의 슈퍼컴퓨터 '딥 블루'가 세계 체스 챔피언을 꺾으며 그 가능성을 증명했습니다.
2️⃣ 숨은 주제 찾기
대량의 문서를 입력하면 잠재 디리클레 할당(LDA) 알고리즘으로 문서 속 핵심 주제(대출·금융기관·현금흐름 등)를 스스로 분류·추출할 수 있게 됐습니다. 2011년에는 금융 문서 특유의 어조를 파악하는 '금융 전문 감성 어휘 사전'이 개발되는 등 전문 사전도 발전했습니다.
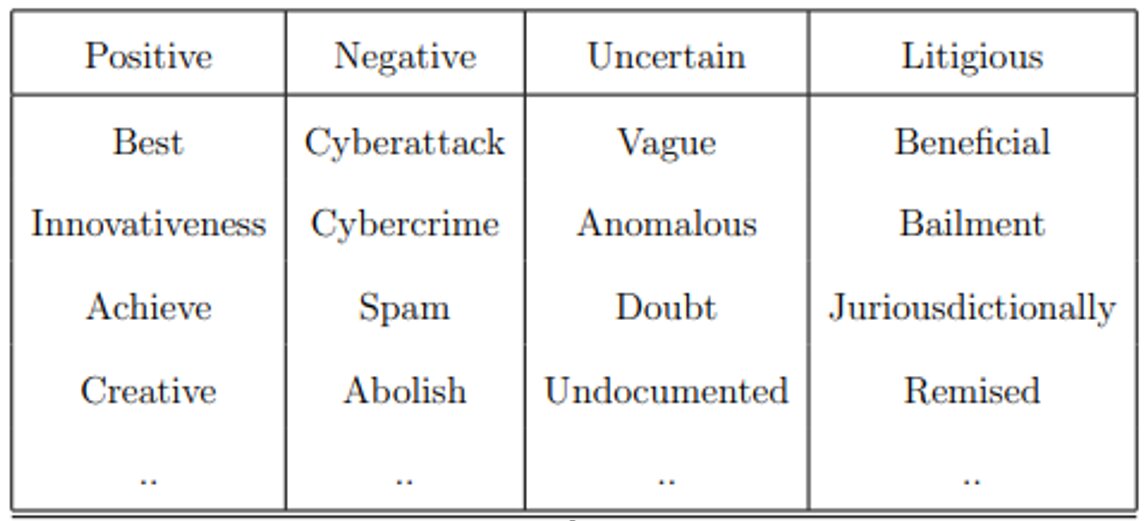
• 출처: Lo, Andrew W., and Manish Singh (2023.06.22)
3️⃣ 단어를 지도로, 단어 임베딩
이 시기 가장 혁신적인 기술은 워드투벡(Word2Vec)과 글로브(GloVe)입니다. 단어의 의미를 수학 공간의 숫자로 바꿔 저장하는 기술인데요.
이를 통해 AI는 '인수(underwriting)' 근처에 '부실(distressed)'이나 '자산담보(asset-backed)' 같은 단어가 모여 있다는 것을 공간상의 거리로
파악해, 단어의 속뜻과 의미 관계를 스스로 이해하게 됐습니다.
4️⃣ 남은 한계
단어의 의미는 파악했지만, 단어가 쓰인 전체 문맥이나 문장의 복잡한 뉘앙스를 매번 완벽히 포착하기는 여전히 어려웠습니다.
■ 지금의 AI는 어떻게 문맥을 이해할까? (2010년대 중반~현재)
1️⃣ 딥러닝 혁명
인간 뇌의 신경망을 모방한 '딥러닝' 구조가 GPU의 연산력과 만나며 AI가 크게 진화했습니다.
2016년 구글 딥마인드의 '알파고'가 이세돌 9단을 꺾으며 전 세계가 딥러닝의 위력을 목격했습니다.
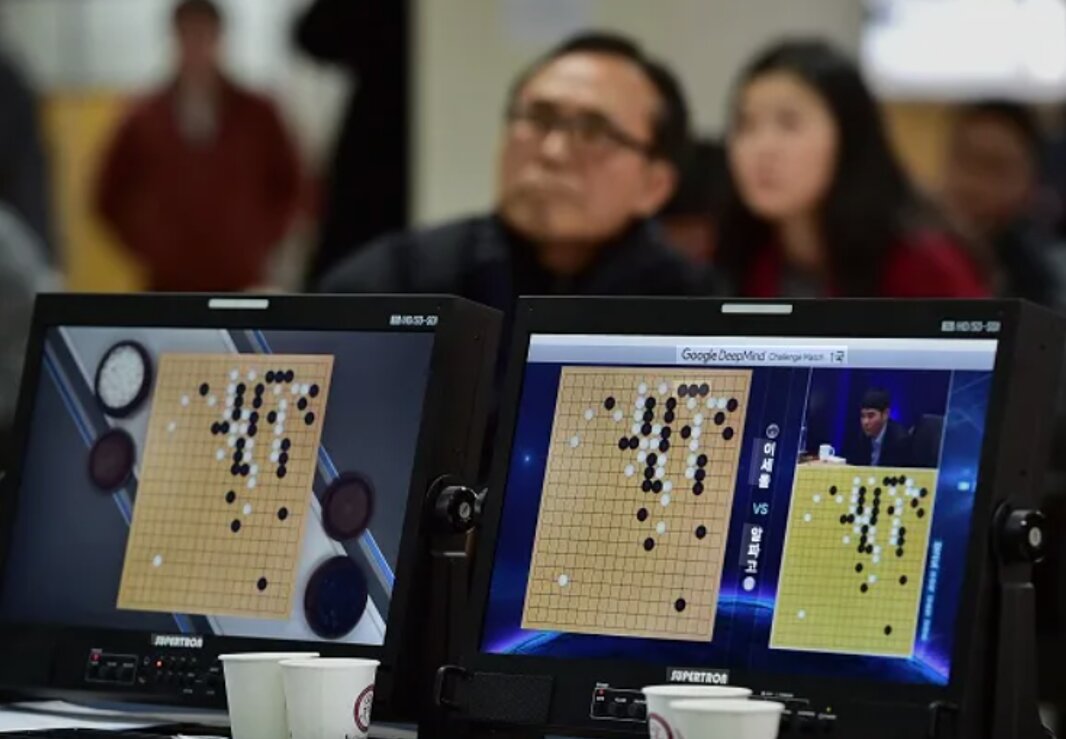
• 출처: Bloomberg (2016.03)
2️⃣ 트랜스포머 혁명
2010년대 초에는 순차적으로 문장을 읽는 RNN과 LSTM이 등장해 문맥 이해가 한층 개선됐지만, 긴 문장을 처리하는 데 한계가 있었습니다.
이를 극복한 것이 2017년 구글이 발표한 '트랜스포머 아키텍처'였습니다. AI에게 문맥 속에서 중요한 것에 집중하는 능력(Self-Attention)'을
부여해, 문장 전체를 한눈에 보며 단어 간의 동적 관계를 파악하게 만들었습니다.
3️⃣ 2단계 학습법
LLM은 먼저 인터넷의 방대한 텍스트를 읽으며 다음 단어를 맞추는 '사전 학습(Pre-training)'으로 언어의 기본 원리를 깨우칩니다.
이후 특정 목적(금융 분석, 일상 대화 등)의 데이터로 가볍게 '미세 조정(Fine-tuning)'을 거쳐 전문가로 거듭납니다.
4️⃣ ChatGPT, 그리고 남은 과제
이 기술을 기반으로 등장한 ChatGPT는 뛰어난 언어 생성력과 창의성을 입증하며 일상과 산업의 표준이 됐습니다.
다만 그럴듯한 거짓을 진짜처럼 답하는 '환각 현상(Hallucination)'이 남아 있고, 완전하고 자율적인 인과관계 추론에는 여전히 약점이 있습니다.
■ 규칙에서 문맥까지, 70년이 남긴 것
AI가 사람의 말을 배워온 역사는 '사람이 정해준 규칙 → 통계적 확률 → 단어의 의미 → 문장 전체의 문맥'을 이해하는 방향으로 진화해 왔습니다.
규칙에서 시작해 통계와 단어 위치를 거쳐, 이제는 문장 전체의 맥락을 이해하는 대형 언어 모델(LLM) 시대에 이른 것입니다.
덕분에 AI는 사람처럼 말을 잘하게 됐지만, 환각 현상이 여전하고 스스로 원인을 추론하는 능력은 아직 부족합니다.
앞으로의 AI는 이런 현실적 문제를 어떻게 풀어내느냐가 과제가 될 것으로 보입니다.

Compliance notice
※ KB자산운용 준법감시인 심사필 투자광고 2025_1313(다) (2025.07.31~2026.07.30)
※ 본 자료는 고객의 투자에 참고가 될 수 있는 각종 정보 제공을 목적으로 제작되었습니다. 본 자료는 계량적 분석에 근거한 의견을 제시하며, 당사의 대표 투자의견과는 다를 수 있습니다.
※ 본 자료는 합리적인 정보를 바탕으로 작성된 것이지만, 투자 권유의 적합성이나 완전성을 보장하지 못합니다. 따라서 투자 판단의 최종 책임은 투자자 본인에게 있으며, 본 자료는 어떠한 경우라도 법적 책임소재의 증빙으로 사용될 수 없습니다.
※ 본 자료는 현재의 시장 상황을 감안하여 참고용으로만 제시된 것이며, 외부의 부당한 압력이나 간섭 없이 작성자 개인의 의견이 반영된 것입니다. 당사는 관련 법령에 허용된 범위 내에서 투자 전략 및
투자 프로세스를 결정하므로, 본 자료에 기재된 사항 중 관련 법령 및 계약서의 내용과 상이한 것은 효력이 없습니다.
※ 본 자료는 당사의 저작물로서 모든 지적재산권은 당사에 귀속되며 당사의 동의 없이 복제, 배포, 전송, 변형, 대여할 수 없습니다. 본 자료를 KB자산운용 임직원 외의 자로부터 입수하였을 경우, 자료 무단 제공 및 이용에 대한 책임은 전적으로 해당 제공자 및 이용자에게 있습니다.
※ 투자자는 투자 의사결정을 하시기 전에 반드시 집합투자규약 및 투자설명서를 수령하여 상품의 내용을 충분히 인지한 후 투자 결정하시기 바라며, 투자 전 판매 회사의 충분한 설명을 청취하시기 바랍니다.
※ 집합투자증권은 운용 결과에 따라 투자원금의 손실(0~100%)이 발생할 수 있으며, 그 손실은 투자자에게 귀속됩니다.
※ 집합투자증권을 취득하시기 전에 투자대상, 보수·수수료 및 환매방법 등에 관하여 (간이) 투자설명서를 반드시 읽어보시기 바랍니다.
※ 이 금융투자상품은 예금자보호법에 따라 보호되지 않습니다.
※ 합성총보수 비용 및 증권거래비용을 함께 고려하시기 바랍니다.
※ 과세 기준 및 방법은 향후 세법개정 등에 따라 변동될 수 있습니다.
※ RISE 미국AI밸류체인 TOP3 Plus ETF: 합성 총보수 : 0.109% (집합투자 : 0.001%, 판매회사 : 0.001%, 신탁업자 : 0.005%, 사무관리 : 0.003%, 기타비용: 0.099%) / 증권 거래비용: 0.386% / 위험 등급: 1등급(매우 높은 위험)
자주 묻는 질문
QAI가 언어를 이해하는 방식은 어떻게 발전해 왔나요?
AI는 초기 규칙 기반 방식에서 시작해 통계적 확률 계산, 단어 의미 파악, 문장 전체 문맥 이해 순으로 발전했습니다. 현재는 트랜스포머 구조를 활용해 문맥 속에서 중요한 부분에 집중하며 언어를 처리합니다.
QChatGPT는 어떤 학습 방법으로 만들어졌나요?
ChatGPT는 2단계 학습법을 사용합니다. 먼저 방대한 텍스트로 다음 단어를 맞추는 사전 학습을 거쳐 언어 원리를 배우고, 이후 특정 목적의 데이터로 미세 조정을 거쳐 전문성을 갖추게 됩니다.
QAI 언어 처리에서 환각 현상이란 무엇인가요?
환각 현상은 AI가 그럴듯한 거짓 정보를 마치 사실처럼 답변하는 현상입니다. 현재 대형 언어 모델이 가진 주요 한계 중 하나로, 완전한 인과관계 추론 능력과 함께 개선이 필요한 과제입니다.
Q1950년대 초기 AI와 현재 AI의 차이는 무엇인가요?
초기 AI는 사람이 미리 정해준 규칙과 사전 안에서만 작동했으며 예외 상황에 대응하지 못했습니다. 현재 AI는 딥러닝과 트랜스포머 기술로 스스로 패턴을 학습하고 문맥을 이해하며 유연하게 언어를 처리합니다.
Q워드투벡과 글로브 기술은 어떤 역할을 했나요?
워드투벡과 글로브는 단어를 수학 공간의 숫자로 변환하는 단어 임베딩 기술입니다. 이를 통해 AI는 의미가 비슷한 단어들이 공간상 가까이 위치한다는 것을 파악하며 단어 간 관계를 이해하게 됐습니다.